Linux
Linux⚡top 명령어를 이용하여 서버 상태 확인하기
도픽트셀
2024. 7. 29. 10:25
top 명령어의 사용
top명령어는 리눅스/유닉스 시스템에서 실시간으로 프로세스 상태를 모니터링하는 도구.
시스템에서 실행 중인 프로세스의 CPU, 메모리 사용량, 시스템 부하 등의 정보를 실시간으로 확인할 수 있습니다.
top
명령어 화면 구성
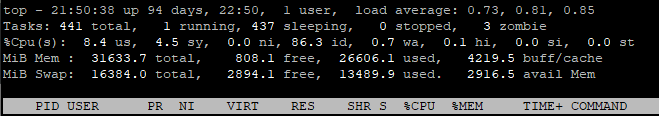
- up : 시스템이 얼마나 오랫동안 동작했는지 확인 가능
- 사용자 세션: 로그인한 사용자의 수.
- 로드 평균(load average): 1분, 5분, 15분 간의 시스템 부하.
※ 숫자가 낮을수록 시스템 부하가 적음 - Tasks: 시스템에서 실행 중인 작업 상태.
- total: 전체 프로세스 수
- running: 실행 중인 프로세스 수
- sleeping: 대기 중인 프로세스 수
- stopped: 정지된 프로세스 수
- zombie: 좀비 프로세스 수
- CPU 사용량: 각 항목은 CPU의 시간 사용을 나타냅니다.
- us: 사용자 영역에서 사용 중인 CPU 시간 (일반 사용자 프로세스)
- sy: 시스템 영역에서 사용 중인 CPU 시간 (커널 프로세스)
- ni: 사용자 프로세스 중에서 nice 값을 변경하여 우선순위를 조정한 프로세스의 CPU 시간
- id: 유휴 시간 (아무 작업도 하지 않는 시간)
- wa: I/O 대기 시간
- hi: 하드웨어 인터럽트 처리 시간
- si: 소프트웨어 인터럽트 처리 시간
- st: 하이퍼바이저가 다른 가상 머신을 서비스하는 데 사용된 시간
- 메모리 사용량: 물리적 메모리와 스왑 메모리의 사용량
- Mem: 사용 중인 물리적 메모리 (total, used, free, buff/cache)
- Swap: 사용 중인 스왑 메모리 (total, used, free, avail Mem)
프로세스 리스트
- PID: 프로세스 ID
- USER: 프로세스를 실행한 사용자
- PR: 프로세스 우선순위
- NI: 프로세스의 nice 값 (우선순위 변경 가능)
- VIRT: 가상 메모리 사용량
- RES: 실제 메모리 사용량
- SHR: 공유 메모리 사용량
- S: 프로세스 상태 (R=Running, S=Sleeping, Z=Zombie, T=Stopped)
- %CPU: CPU 사용 비율
- %MEM: 메모리 사용 비율
- TIME+: 프로세스가 사용한 총 CPU 시간
- COMMAND: 실행 중인 명령어 또는 프로세스 이름
top 명령어에서 사용할 수 있는 키
- q: top 명령어 종료
- h: 도움말 보기
- k: 프로세스 종료 (PID 입력 후 종료할 프로세스 지정)
- r: 프로세스 우선순위 변경 (PID 입력 후 nice 값 조정)
- P: CPU 사용률 기준으로 정렬
- M: 메모리 사용률 기준으로 정렬
- T: 프로세스 실행 시간 기준으로 정렬
- 1: CPU별 사용량 표시 (멀티코어 CPU의 경우 각 코어별로 사용량을 볼 수 있음)
- f: 출력 필드 추가/삭제 및 정렬 설정 변경
top 명령어 옵션
- -u 사용자: 특정 사용자의 프로세스만 보기
top -u root - -p PID: 특정 PID의 프로세스만 모니터링
top -p 1234 - -d 간격: 업데이트 간격 설정 (초 단위, 기본 3초)
top -d 5
Load Average
시스템의 부하 정도를 나타내는 중요한 지표로, 주로 리눅스 및 유닉스 계열 시스템에서 시스템 상태를 모니터링할 때 사용
일정 기간 동안 시스템의 CPU에 대기 중이거나 실행 중인 작업의 평균 개수를 나타냄. 여기서 '작업'은 주로 CPU에 대한 요청을 의미하며, I/O 작업이나 메모리 대기 작업도 포함. 주로 3개의 숫자로 나타나며, 각 숫자는 다른 시간 간격의 평균 표출.

- 첫 번째 숫자 (0.53): 1분 동안의 평균 부하
- 두 번째 숫자 (0.60): 5분 동안의 평균 부하
- 세 번째 숫자 (0.73): 15분 동안의 평균 부하
CPU 코어 수에 따라 상태의 해석이 다름
- 싱글코어 시스템: 1.0은 CPU가 풀로 사용되고 있는 상태. 1.0 이상이면 CPU 과부하, 대기 상태가 생김.
- 듀얼코어 시스템 (코어 2개): 2.0까지는 정상적인 상태로 간주. 2.0을 넘으면 대기 중인 프로세스가 발생하는 과부하 상태.
- 쿼드코어 시스템 (코어 4개): 4.0까지는 CPU가 적절히 사용되고 있는 상태로 볼 수 있습니다. 이 이상이면 대기 중인 프로세스가 많다는 의미.
Load Average가 높아지는 이유
- CPU 집약적인 작업: CPU 자원을 많이 사용하는 작업이 많을 때 부하가 증가. 예를 들어, 데이터 분석, 대규모 컴파일, 비디오 인코딩 같은 작업들.
- I/O 병목: 디스크나 네트워크 I/O가 느리거나 작업이 대기 중일 때도 load average가 높아질 수 있다.
- 메모리 부족: 물리적 메모리가 부족해 스왑이 많이 발생하면 CPU 대기 시간이 길어져서 load average가 증가할 수 있다.
- 프로세스의 비효율적인 동작: 잘못된 스크립트나 효율적이지 못한 애플리케이션이 CPU를 많이 차지할 수 있다.